Pandas en Python: tus primeros pasos con un dataset real

Pandas en Python: tus primeros pasos con un dataset real

Pandas en Python: tus primeros pasos con un dataset real

Por:

Franco Brutti

·

Fecha de Actualización:

Pandas es la librería de Python para trabajar con tablas: lees un fichero, lo inspeccionas, lo limpias, filtras filas y resumes con groupby. En este tutorial lo haces con 139.860 filas reales del INE, sin registrarte ni descargar nada a mano. Todo el código lo ejecuté el 30-10-2026 con Python 3.13.15 y pandas 3.1.0.

Al terminar habrás cargado un CSV de verdad, habrás esquivado dos trampas que te encontrarás en datos reales y tendrás un ranking de comunidades autónomas sacado con tres líneas. No hace falta experiencia previa con pandas. Con saber qué es una variable y cómo ejecutar un script de Python tienes de sobra.

Si todavía no tienes claro dónde encaja Python en el trabajo con datos, antes te sirve el artículo sobre Python para data science: qué es, usos y ventajas. Aquí vamos directos a la práctica.

Qué necesitas y qué dataset vas a usar

Necesitas Python 3.11 o superior, un terminal y conexión a internet. El dataset es la tabla 2074 del INE, «Viajeros y pernoctaciones por comunidades autónomas y provincias», de la Encuesta de Ocupación Hotelera. Se descarga por URL, sin clave, y tiene datos mensuales desde enero de 1999.

Elegí este fichero porque es de verdad: tiene huecos, separadores poco habituales y varios niveles territoriales mezclados en la misma tabla. Justo lo que no verás en los CSV de ejemplo de muchos tutoriales.

Sobre la licencia. Según el aviso legal del INE, puedes reutilizar sus datos, también con fines comerciales, citando la fuente. Si los tratas, como haremos aquí, la cita es «Elaboración propia con datos extraídos del sitio web del INE: www.ine.es». Los datos se publican cada mes, así que el último periodo que veas será posterior al que aparece en este texto (septiembre de 2026) y tus cifras del último mes cambiarán.

El mínimo de Python es la 3.11 porque, según las novedades de pandas 3.0, esa versión de pandas funciona con Python 3.11 o superior.

Paso 1: instala pandas en un entorno virtual

Crea un entorno virtual, actívalo e instala pandas con pip. Es lo que recomienda la guía de instalación de pandas: así no mezclas librerías de distintos proyectos ni tocas el Python del sistema. Después comprueba la versión que se ha instalado, para saber exactamente con qué trabajas y poder comparar tus resultados con los míos.

python -m venv .venv
source .venv/bin/activate
pip install pandas
python -c "import pandas as pd; print(pd.__version__)"
python -m venv .venv
source .venv/bin/activate
pip install pandas
python -c "import pandas as pd; print(pd.__version__)"
python -m venv .venv
source .venv/bin/activate
pip install pandas
python -c "import pandas as pd; print(pd.__version__)"

En Windows, el segundo comando es .venv\Scripts\activate. Yo obtuve esto:

3.1.0
3.1.0
3.1.0

Si te sale otra versión, no pasa nada. Las diferencias que importan entre pandas 2 y pandas 3 las explico más abajo, en las preguntas frecuentes. Crea ahora un fichero primeros_pasos.py: el código de los siguientes pasos va dentro, uno detrás de otro.

Paso 2: lee el CSV con read_csv (y por qué falla a la primera)

pd.read_csv convierte un fichero de texto en un DataFrame, la tabla de pandas. Este CSV separa las columnas con tabuladores y escribe los miles con punto, así que hay que decírselo. Y esconde una trampa: el INE marca los datos que faltan con un punto solo.

Empieza leyéndolo sin ayudar a pandas más que con el separador:

import pandas as pd

URL = "https://servicios.ine.es/wstempus/csv/ES/DATOS_TABLA/2074"

mal = pd.read_csv(URL, sep="\t")
print(mal["Total"].dtype)
import pandas as pd

URL = "https://servicios.ine.es/wstempus/csv/ES/DATOS_TABLA/2074"

mal = pd.read_csv(URL, sep="\t")
print(mal["Total"].dtype)
import pandas as pd

URL = "https://servicios.ine.es/wstempus/csv/ES/DATOS_TABLA/2074"

mal = pd.read_csv(URL, sep="\t")
print(mal["Total"].dtype)
str
str
str

La columna Total debería ser un número y es texto. Con los miles escritos como «12.261.521», pandas no puede convertirla. Prueba con thousands=".":

df = pd.read_csv(URL, sep="\t", thousands=".")
print(df["Total"].dtype)
df = pd.read_csv(URL, sep="\t", thousands=".")
print(df["Total"].dtype)
df = pd.read_csv(URL, sep="\t", thousands=".")
print(df["Total"].dtype)

Seguirá siendo texto (lo comprobé). El motivo es que 75 celdas contienen solo un «.», que el INE usa para indicar que no hay dato. Ese punto choca con el separador de miles. La documentación de read_csv describe thousands como el carácter que actúa de separador de miles, y na_values como cadenas extra que se reconocen como dato ausente. Usa las dos:

df = pd.read_csv(URL, sep="\t", thousands=".", na_values=["."])
print(df.shape)
print(df["Total"].dtype)
df = pd.read_csv(URL, sep="\t", thousands=".", na_values=["."])
print(df.shape)
print(df["Total"].dtype)
df = pd.read_csv(URL, sep="\t", thousands=".", na_values=["."])
print(df.shape)
print(df["Total"].dtype)
(139860, 8)
float64
(139860, 8)
float64
(139860, 8)
float64

Ahora sí: 139.860 filas, 8 columnas y Total como número decimal. Este es el patrón de cualquier CSV con formato español: separador, miles y marca de dato ausente, y comprobar el tipo de la columna antes de seguir.

Paso 3: mira qué has cargado antes de tocar nada

Antes de filtrar, mira el dataset con head, info y la cuenta de nulos. Son tres llamadas que responden a tres preguntas: cómo son las filas, de qué tipo es cada columna y dónde faltan datos. Quien se salta este paso suele descubrir el problema dos pasos más tarde.

print(df.head(3).to_string())
df.info()
print(df.isna().sum())
print(df.head(3).to_string())
df.info()
print(df.isna().sum())
print(df.head(3).to_string())
df.info()
print(df.isna().sum())

La salida (resumida):

  Totales Territoriales Comunidades y Ciudades Autónomas Provincias Viajeros y pernoctaciones Residencia: Nivel 1 Residencia: Nivel 2  Periodo       Total
0        Total Nacional                              NaN        NaN                   Viajero               Total                 NaN  2026M09  12261521.0
1        Total Nacional                              NaN        NaN                   Viajero               Total                 NaN  2026M08  14227157.0
2        Total Nacional                              NaN        NaN                   Viajero               Total                 NaN  2026M07  13208858.0

Comunidades y Ciudades Autónomas     1998
Provincias                          39960
Residencia: Nivel 2                 46620
Total                                  85

Hay tres cosas que leer. Primera: la fila 0 es el total nacional de viajeros en septiembre de 2026, 12.261.521, y sus columnas de comunidad y provincia están vacías. Segunda: Periodo es un texto del tipo 2026M09, no una fecha. Tercera: los nulos de comunidad, provincia y residencia no son errores, indican el nivel de la fila. Una fila sin comunidad ni provincia es un total nacional.

En info() verás los textos con tipo str. En pandas 3 es el tipo por defecto para columnas de texto, según las novedades de la versión. En pandas 2 verías object.

Paso 4: renombra columnas y convierte el periodo en fecha

Limpiar es dejar las columnas con nombres cómodos y los tipos correctos. Con rename acortas los nombres y con pd.to_datetime conviertes 2026M09 en una fecha real. Desde ahí puedes extraer el año y el mes, filtrar por fechas, comparar periodos y ordenar de forma cronológica.

df = df.rename(columns={
    "Totales Territoriales": "ambito",
    "Comunidades y Ciudades Autónomas": "comunidad",
    "Provincias": "provincia",
    "Viajeros y pernoctaciones": "medida",
    "Residencia: Nivel 1": "residencia1",
    "Residencia: Nivel 2": "residencia2",
    "Periodo": "periodo",
    "Total": "valor",
})
df["fecha"] = pd.to_datetime(df["periodo"], format="%YM%m")
df["anio"] = df["fecha"].dt.year
print(df[["periodo", "fecha", "anio"]].head(2).to_string())
print(df["fecha"].min(), df["fecha"].max())
   periodo      fecha  anio
0  2026M09 2026-09-01  2026
1  2026M08 2026-08-01  2026
1999-01-01 00:00:00 2026-09-01 00:00:00
   periodo      fecha  anio
0  2026M09 2026-09-01  2026
1  2026M08 2026-08-01  2026
1999-01-01 00:00:00 2026-09-01 00:00:00
   periodo      fecha  anio
0  2026M09 2026-09-01  2026
1  2026M08 2026-08-01  2026
1999-01-01 00:00:00 2026-09-01 00:00:00

El parámetro format="%YM%m" le dice a pandas cómo está escrita la fecha: año de cuatro cifras, una «M» literal y el mes. La documentación de to_datetime explica el resto de códigos. Y fíjate en que reasignamos df = df.rename(...): rename devuelve una tabla nueva y, si no guardas el resultado, el cambio se pierde.

Paso 5: la trampa de sumar todas las filas

En este dataset, el total nacional, cada comunidad y cada provincia viven en la misma columna. Si sumas valor sin filtrar, cuentas varias veces lo mismo. Es el error más caro de los primeros proyectos con datos: el código funciona, el resultado es un número plausible y está mal.

Compruébalo con septiembre de 2026, solo viajeros y solo filas de total de residencia:

sep26 = df[(df["fecha"] == "2026-09-01") & (df["medida"] == "Viajero")
           & (df["residencia2"].isna())]
print("suma de todas las filas:", sep26["valor"].sum())
nacional = sep26[sep26["comunidad"].isna() & sep26["provincia"].isna()]
print("fila Total Nacional:", nacional["valor"].iloc[0])
sep26 = df[(df["fecha"] == "2026-09-01") & (df["medida"] == "Viajero")
           & (df["residencia2"].isna())]
print("suma de todas las filas:", sep26["valor"].sum())
nacional = sep26[sep26["comunidad"].isna() & sep26["provincia"].isna()]
print("fila Total Nacional:", nacional["valor"].iloc[0])
sep26 = df[(df["fecha"] == "2026-09-01") & (df["medida"] == "Viajero")
           & (df["residencia2"].isna())]
print("suma de todas las filas:", sep26["valor"].sum())
nacional = sep26[sep26["comunidad"].isna() & sep26["provincia"].isna()]
print("fila Total Nacional:", nacional["valor"].iloc[0])
suma de todas las filas: 36775920.0
fila Total Nacional: 12261521.0
suma de todas las filas: 36775920.0
fila Total Nacional: 12261521.0
suma de todas las filas: 36775920.0
fila Total Nacional: 12261521.0

La suma ingenua da casi el triple que el total nacional: 36.775.920 frente a 12.261.521. El motivo es que nacional, comunidades y provincias cuentan a los mismos viajeros en tres niveles. La regla que te llevas es sencilla. Antes de sumar, pregúntate qué representa exactamente cada fila y filtra un solo nivel.

¿Te gusta trabajar con datos?

El máster en AI Data Analytics te enseña a convertir datos en decisiones con IA generativa desde el primer módulo. Descarga el dossier y mira el plan de estudios.

Descargar el dossier →

Paso 6: filtra solo comunidades autónomas

Filtrar con pandas es escribir condiciones sobre columnas y combinarlas con &. Para quedarte con las comunidades, necesitas viajeros, comunidad informada, provincia vacía y residencia en el nivel total. Cada condición va entre paréntesis y el resultado es un DataFrame nuevo, más pequeño.

ccaa = df[(df["medida"] == "Viajero") & df["comunidad"].notna()
          & df["provincia"].isna() & df["residencia2"].isna()]
print(ccaa.shape)
madrid = ccaa[ccaa["comunidad"] == "13 Madrid, Comunidad de"]
print(madrid[["fecha", "valor"]].head(3).to_string())
ccaa = df[(df["medida"] == "Viajero") & df["comunidad"].notna()
          & df["provincia"].isna() & df["residencia2"].isna()]
print(ccaa.shape)
madrid = ccaa[ccaa["comunidad"] == "13 Madrid, Comunidad de"]
print(madrid[["fecha", "valor"]].head(3).to_string())
ccaa = df[(df["medida"] == "Viajero") & df["comunidad"].notna()
          & df["provincia"].isna() & df["residencia2"].isna()]
print(ccaa.shape)
madrid = ccaa[ccaa["comunidad"] == "13 Madrid, Comunidad de"]
print(madrid[["fecha", "valor"]].head(3).to_string())
(6327, 10)
            fecha      valor
111888 2026-09-01  1193964.0
111889 2026-08-01  1082623.0
111890 2026-07-01  1139288.0
(6327, 10)
            fecha      valor
111888 2026-09-01  1193964.0
111889 2026-08-01  1082623.0
111890 2026-07-01  1139288.0
(6327, 10)
            fecha      valor
111888 2026-09-01  1193964.0
111889 2026-08-01  1082623.0
111890 2026-07-01  1139288.0

De 139.860 filas has pasado a 6.327, que son 19 territorios (17 comunidades y las dos ciudades autónomas) por 333 meses. Y la comunidad de Madrid tuvo 1.193.964 viajeros alojados en hoteles en septiembre de 2026. Observa que las comunidades vienen con un número delante («13 Madrid, Comunidad de»): es el código del INE, y hay que escribirlo tal cual en el filtro.

Paso 7: agrupa y ordena con groupby

groupby divide la tabla en grupos, aplica una operación a cada uno y junta los resultados. Aquí agrupas por comunidad, sumas los viajeros de los doce meses de 2025 y ordenas de mayor a menor. Es la operación más usada en análisis de datos, y en pandas cabe en una expresión.
por_anio = (ccaa[ccaa["anio"] == 2025]
            .groupby("comunidad")["valor"].sum()
            .sort_values(ascending=False))
print(por_anio.head(5).to_string())
por_anio = (ccaa[ccaa["anio"] == 2025]
            .groupby("comunidad")["valor"].sum()
            .sort_values(ascending=False))
print(por_anio.head(5).to_string())
por_anio = (ccaa[ccaa["anio"] == 2025]
            .groupby("comunidad")["valor"].sum()
            .sort_values(ascending=False))
print(por_anio.head(5).to_string())
comunidad
09 Cataluña                22635099.0
01 Andalucía               20334166.0
13 Madrid, Comunidad de    13273721.0
04 Balears, Illes          12452052.0
05 Canarias                11322717.0
comunidad
09 Cataluña                22635099.0
01 Andalucía               20334166.0
13 Madrid, Comunidad de    13273721.0
04 Balears, Illes          12452052.0
05 Canarias                11322717.0
comunidad
09 Cataluña                22635099.0
01 Andalucía               20334166.0
13 Madrid, Comunidad de    13273721.0
04 Balears, Illes          12452052.0
05 Canarias                11322717.0
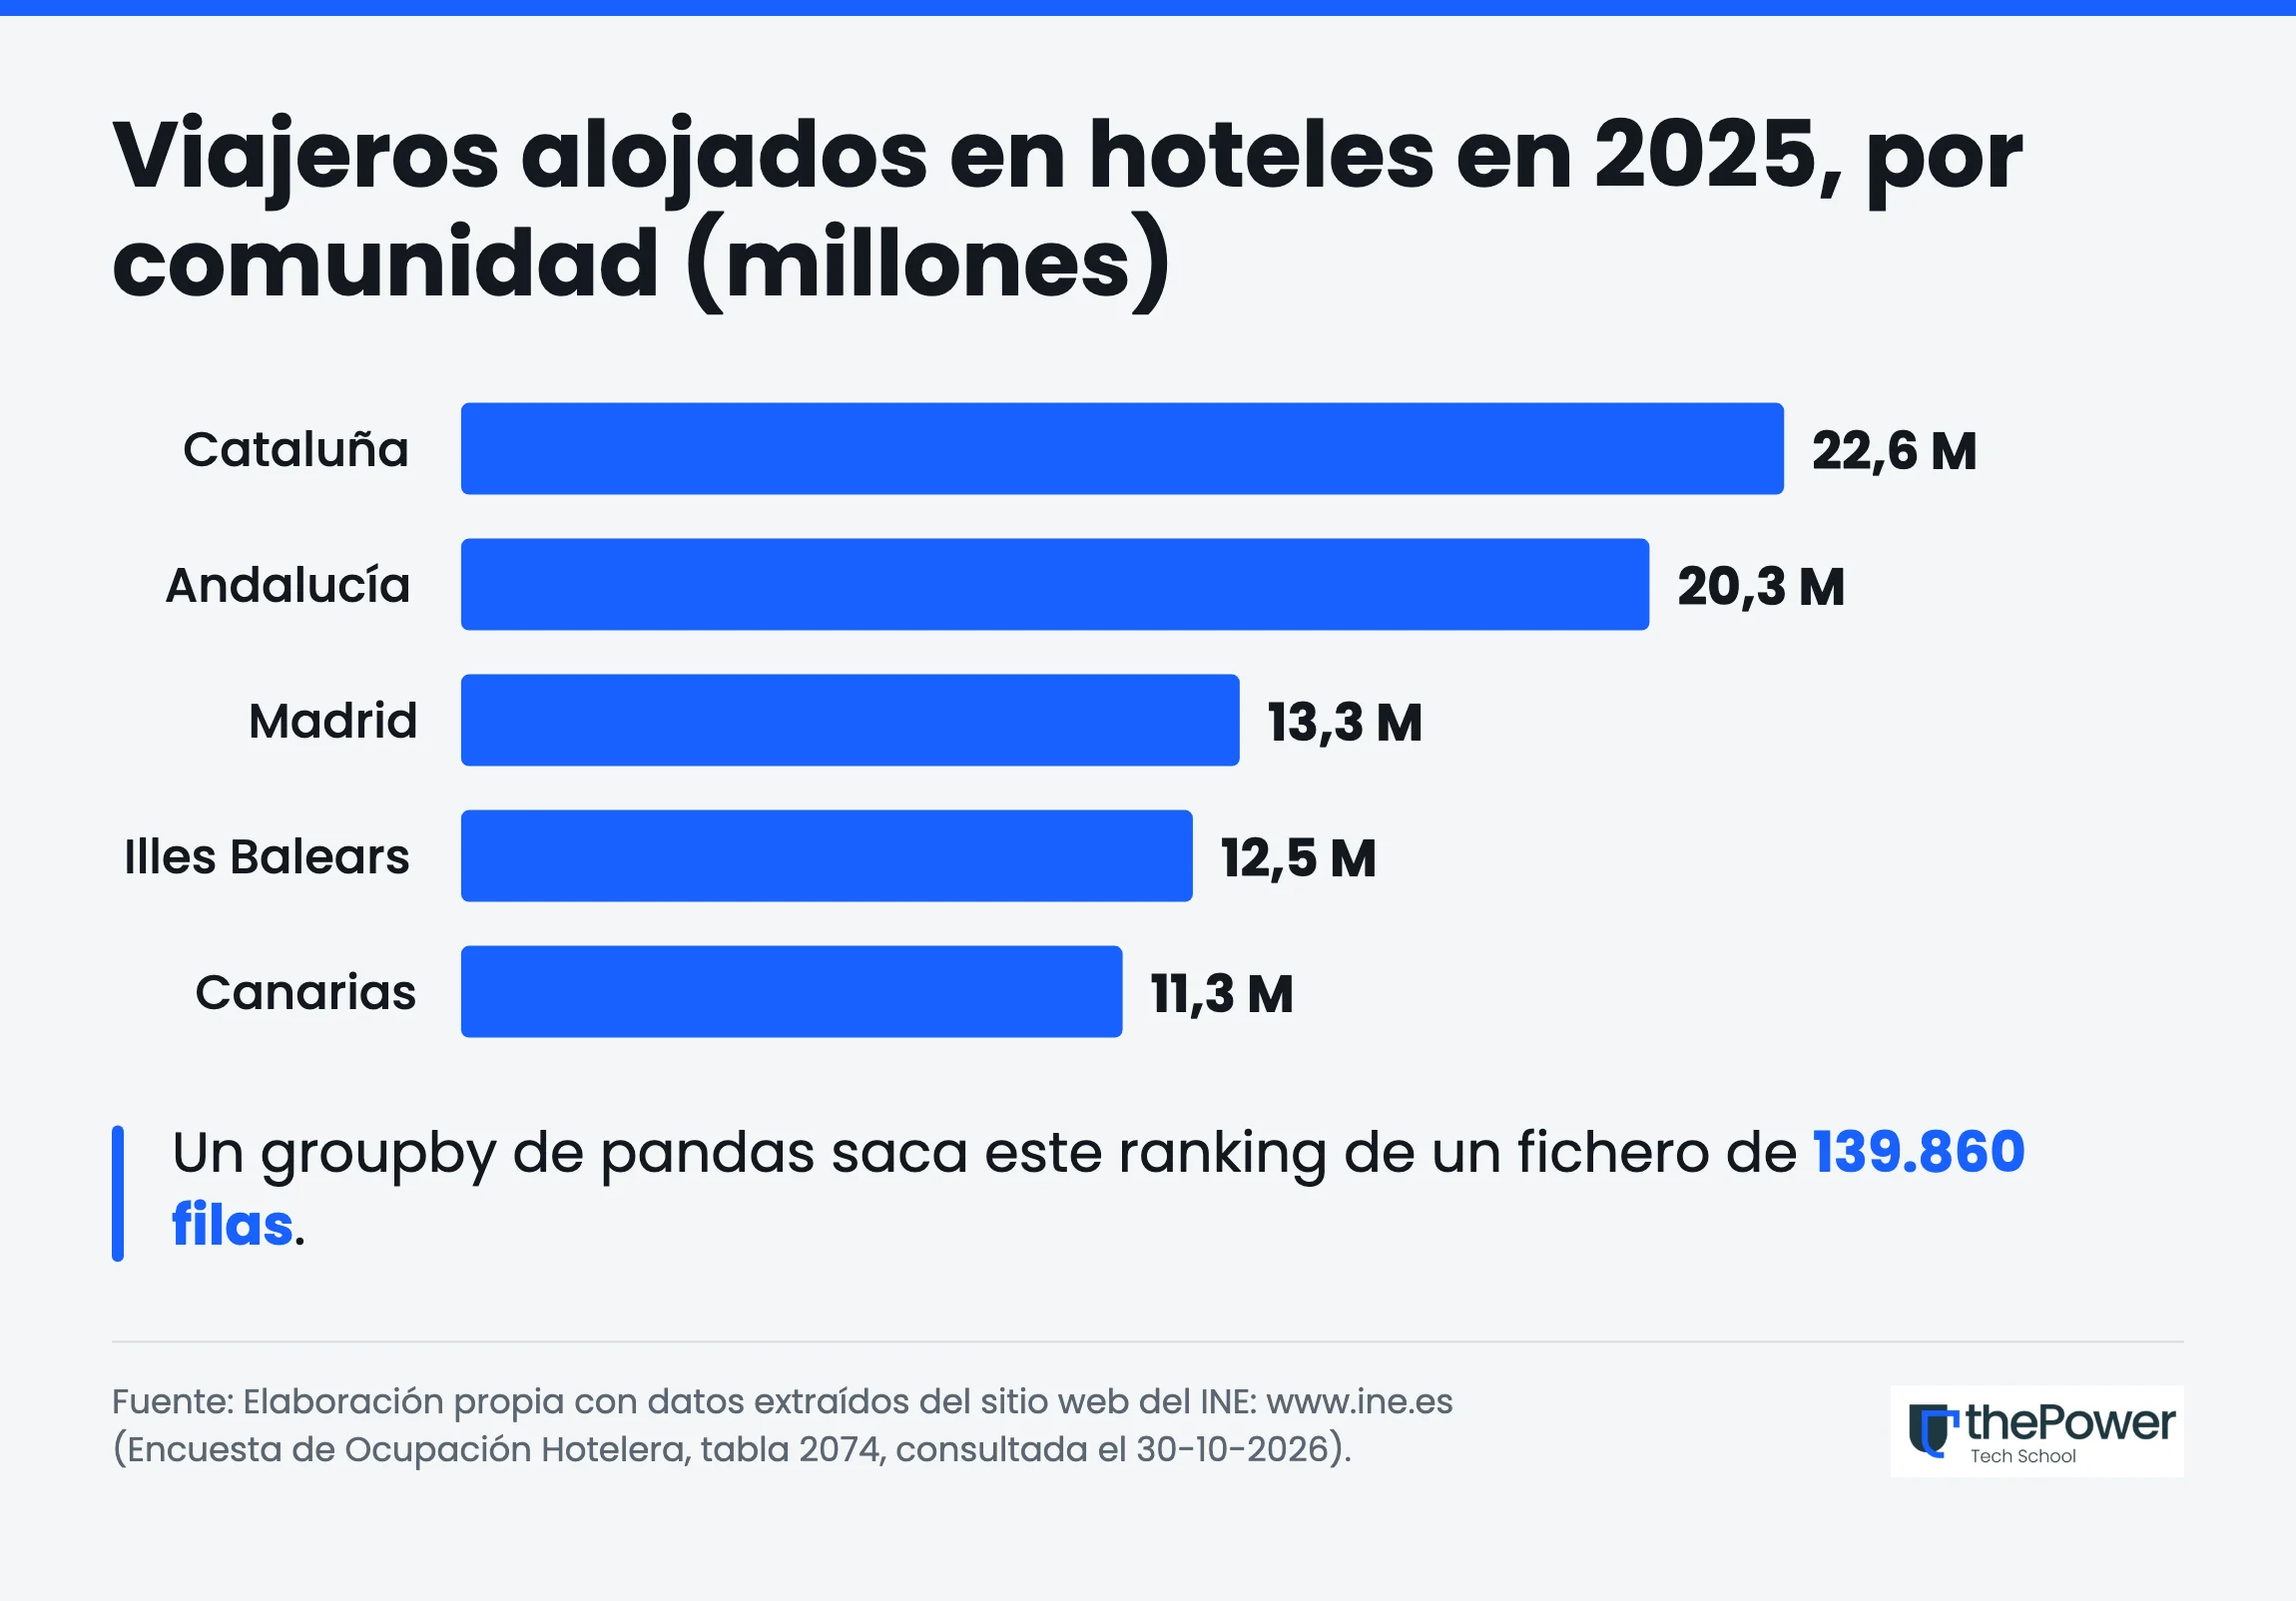
Ranking de comunidades autónomas por viajeros alojados en hoteles en 2025: Cataluña, Andalucía, Madrid, Illes Balears y Canarias

Cataluña y Andalucía encabezan el ranking de 2025, con 22,6 y 20,3 millones de viajeros en hoteles. La documentación de groupby detalla otras operaciones posibles además de sum: mean, count, max, o varias a la vez con agg. Cambia sum por mean y mira qué pasa: así se aprende.

Paso 8: compara periodos con pivot_table

pivot_table reorganiza los datos: lo que era una columna de categorías pasa a ser columnas de la tabla. Es la forma cómoda de comparar. Con ella puedes ver, para septiembre, cuántos viajeros residentes en España y en el extranjero recibió Madrid cada año, y mirar solo 2019 y 2025.

tabla = (df[(df["medida"] == "Viajero") & (df["comunidad"] == "13 Madrid, Comunidad de")
            & df["provincia"].isna() & df["residencia2"].notna()
            & (df["fecha"].dt.month == 9)]
         .pivot_table(index="anio", columns="residencia2", values="valor"))
print(tabla.loc[[2019, 2025]].to_string())
residencia2  Residentes en España  Residentes en el Extranjero
anio                                                          
2019                     504841.0                     574638.0
2025                     519932.0                     627233.0
residencia2  Residentes en España  Residentes en el Extranjero
anio                                                          
2019                     504841.0                     574638.0
2025                     519932.0                     627233.0
residencia2  Residentes en España  Residentes en el Extranjero
anio                                                          
2019                     504841.0                     574638.0
2025                     519932.0                     627233.0

En septiembre de 2019, Madrid recibió 504.841 viajeros residentes en España y 574.638 residentes en el extranjero. En septiembre de 2025, 519.932 y 627.233. Aquí el filtro cambia respecto al paso 6: usamos residencia2.notna() para quedarnos con las filas desglosadas por residencia, no con las de total. Una pregunta distinta pide un filtro distinto.

Paso 9: guarda el resultado en un CSV

Lo último del flujo es sacar tu resultado del script. to_csv guarda cualquier DataFrame o serie en un fichero que puedes abrir con Excel o compartir. Así cierras el ciclo completo del análisis, de principio a fin: leer, inspeccionar, limpiar, filtrar, agrupar y entregar un resultado.

por_anio.to_csv("viajeros_2025_por_comunidad.csv")
print(open("viajeros_2025_por_comunidad.csv").read().splitlines()[:3])
por_anio.to_csv("viajeros_2025_por_comunidad.csv")
print(open("viajeros_2025_por_comunidad.csv").read().splitlines()[:3])
por_anio.to_csv("viajeros_2025_por_comunidad.csv")
print(open("viajeros_2025_por_comunidad.csv").read().splitlines()[:3])
['comunidad,valor', '09 Cataluña,22635099.0', '01 Andalucía,20334166.0']
['comunidad,valor', '09 Cataluña,22635099.0', '01 Andalucía,20334166.0']
['comunidad,valor', '09 Cataluña,22635099.0', '01 Andalucía,20334166.0']

Ejecuta el fichero entero con python primeros_pasos.py. Cada vez que lo ejecutas, lee el CSV directamente de internet. Si algún día el INE cambia la estructura de la tabla, el filtro del paso 6 será lo primero que habrá que revisar.

Qué has aprendido y por dónde seguir

Has recorrido el esqueleto de casi cualquier análisis con pandas: read_csv con los parámetros del fichero, head/info/isna para mirar, rename y to_datetime para limpiar, condiciones booleanas para filtrar, groupby y pivot_table para resumir y to_csv para guardar. Con otro dataset, solo cambian los nombres.

Para seguir, tienes tres ideas. Dibuja la evolución mensual de Madrid con la guía de Matplotlib para visualizar datos. Entiende lo que hay debajo de pandas con el artículo sobre NumPy y el cálculo con matrices. Y recorre la guía de primeros pasos de la documentación de pandas y su «10 minutes to pandas».

Haz también un ejercicio propio: calcula la media mensual de pernoctaciones de Canarias en 2025. Te obliga a cambiar medida y a pensar qué nivel de fila necesitas.

De este tutorial al trabajo de analista de datos

Lo que has hecho hoy es el trabajo diario de un analista, a pequeña escala: coger un fichero ajeno, entenderlo, limpiarlo y sacar una respuesta. Si quieres convertirlo en profesión, el máster en AI Data Analytics de The Power incluye Python en su plan de estudios, junto a SQL, estadística, Power BI y visualización.

La ficha del máster (consultada el 30-10-2026) lo presenta así: «Aprende a convertir datos en decisiones con IA generativa desde el primer módulo». Ofrece dos especializaciones, Business Intelligence y Analytics Engineer, y esta segunda menciona SQL, Python, PySpark y dbt entre sus herramientas. También indica que no necesitas conocimientos previos. Si te interesa saber qué hace el puesto día a día, lo explicamos en qué es un data analyst y qué skills necesita.

Del dataset del INE a tu carrera como analista

Descarga el dossier del máster en AI Data Analytics y descubre las dos especializaciones, Business Intelligence y Analytics Engineer.

Descargar el dossier →

Preguntas frecuentes sobre pandas

¿Qué es pandas y para qué sirve?

Pandas es una librería de Python para analizar datos en forma de tabla. Su objeto principal es el DataFrame, con filas y columnas. Sirve para leer ficheros como CSV o Excel, limpiar valores, filtrar, agrupar y resumir. Es la herramienta habitual cuando una hoja de cálculo se queda corta o necesitas repetir el análisis sin hacerlo a mano.

¿Necesito saber Python antes de aprender pandas?

Conviene saber lo básico: variables, listas, diccionarios, ejecutar un script e importar una librería. Con eso puedes seguir este tutorial. Pandas se aprende mejor sobre la marcha, con datos y preguntas reales, que leyendo toda su documentación antes. Si algo te falla, copia el mensaje de error: casi siempre explica qué columna o parámetro está mal.

¿Cómo leo un CSV con formato español en pandas?

Usa read_csv con tres parámetros: sep para el separador (por ejemplo ";" o "\t"), decimal="," si los decimales llevan coma y thousands="." si los miles llevan punto. Si el fichero marca los datos que faltan con un símbolo propio, indícalo en na_values. Después comprueba con dtype que las columnas numéricas son números.

¿Qué ha cambiado en pandas 3?

Según las novedades de pandas 3.0, el texto usa por defecto un tipo propio, str, en lugar de object, y la asignación encadenada deja de funcionar porque cada operación se comporta como una copia. Exige Python 3.11 o superior. Si vienes de pandas 2, actualiza antes a la 2.3 y revisa los avisos.

¿Pandas sustituye a Excel?

No necesariamente. Excel es cómodo para mirar y retocar datos a mano. Pandas gana cuando el fichero es grande, cuando quieres repetir el mismo análisis cada mes o cuando necesitas dejar por escrito los pasos que has seguido. Muchos analistas usan las dos herramientas, según la tarea.

Comparte este artículo
Usar IA para programar vs programar con IA: la diferencia real

Usar IA para programar vs programar con IA: la diferencia real

Hay una diferencia real entre usar IA para programar y programar con IA. Uno acelera tu flujo. El otro cambia completamente qué puedes construir.

Ver artículo

Mapas de Karnaugh: cómo simplificar funciones lógicas paso a paso

Mapas de Karnaugh: cómo simplificar funciones lógicas paso a paso

Qué es un mapa de Karnaugh, por qué el orden es 00, 01, 11, 10 y cómo agrupar bien, con un ejemplo resuelto de 4 variables y condiciones indiferentes.

Ver artículo

https://thepower.education/blog/tech/de-developer-backend-a-agentic-developer

De developer backend a Agentic Developer: hoja de ruta paso a paso

Si ya desarrollas en backend o fullstack, tienes más de la mitad del camino hecho para convertirte en Agentic Developer. Esta es la ruta concreta paso a paso.

Ver artículo

Programar con IA: el nuevo Full Stack Developer y cómo formarte

Programar con IA: el nuevo Full Stack Developer y cómo formarte

Programar con IA es más que autocompletar código. Descubre qué hace el Full Stack Developer con IA, cuánto gana en España y cómo aprender desde cero.

Ver artículo

Herramientas ciberseguridad: guía técnica

Herramientas de ciberseguridad: lo que usa un profesional para proteger su sistema

Las herramientas de ciberseguridad que usa un profesional para proteger su sistema, cómo configurarlas y cuándo usar cada una. Guía técnica para 2026.

Ver artículo

Perfil Desarrollador Agéntico: habilidades y salidas en 2026

Perfil del Desarrollador Agéntico: habilidades y salidas profesionales en 2026

Descubre qué habilidades define el perfil de un desarrollador agéntico, qué roles existen en el mercado y cuánto gana este perfil en España en 2026.

Ver artículo

En tech, quien no se forma cada año, se queda atrás

VER MÁSTERS TECH

VER MÁSTERS TECH

Business & IA

Tech & Data

Pharma

FP Oficial

Oposiciones

Oficios

In Company