Si últimamente estás escuchando hablar de RAG cada vez que alguien menciona modelos de lenguaje (LLMs) como ChatGPT, Gemini o Claude, no es casualidad. RAG se está convirtiendo en una de las piezas más importantes para llevar la IA del “demo que impresiona” a soluciones realmente útiles en empresas.
¿Te imaginas por qué? El motivo es simple: los LLMs son muy buenos generando texto, pero tienen un límite claro en contextos profesionales.
Genérica (demasiado amplia o poco accionable)
Desactualizada (porque el modelo no “sabe” lo último que pasó)
o directamente inventada (alucinaciones) cuando no tiene datos fiables
Y si ya es molesto ver cómo se equivoca, en una empresa, eso puede ser un problema real: una respuesta errónea en soporte, una política interna mal citada o un dato comercial equivocado puede costar tiempo, dinero y confianza.
Ahí es donde entra RAG: una forma de hacer que un modelo de lenguaje responda con información real, específica y actualizada, sacada de tus propios documentos o fuentes de datos, sin necesidad de reentrenar el modelo.
Qué es RAG (definición clara y simple)
RAG son las siglas de Retrieval-Augmented Generation (generación aumentada por recuperación de información).
En una frase: es una técnica que hace que un modelo de lenguaje responda usando información externa y específica —tus documentos, tus datos— en lugar de basarse solo en lo que “sabe” por su entrenamiento.
El modelo primero busca la información relevante y luego genera la respuesta apoyándose en ella.
Explicado de la manera más sencilla
Imagina dos escenarios:
LLM sin RAG:
Es como un empleado muy inteligente, pero que responde solo con lo que recuerda de memoria.LLM con RAG:
Es ese mismo empleado, pero con acceso en tiempo real a tus documentos, bases de conocimiento y políticas internas, y que los consulta antes de responder.
La diferencia no está en que el modelo sea “más inteligente”, sino en que responde con la información correcta en el momento adecuado.
Diferencia clave entre un LLM “solo” y un sistema con RAG
Aspecto | LLM “solo” (sin RAG) | LLM con RAG |
|---|---|---|
Fuente de información | Conocimiento aprendido durante el entrenamiento | Documentos y datos externos en tiempo real |
Actualización de datos | Limitada al momento del entrenamiento | Puede usar información actualizada sin reentrenar |
Nivel de personalización | Genérico | Adaptado a tu empresa, producto o contexto |
Riesgo de alucinaciones | Medio–alto cuando no tiene datos claros | Mucho menor (se apoya en fuentes reales) |
Uso de información interna | No puede acceder a datos propios | Usa documentación interna y privada |
Fiabilidad en entornos profesionales | Limitada | Alta |
Casos ideales | Preguntas generales, creatividad, brainstorming | Soporte, ventas, RRHH, compliance, documentación |
Un LLM “solo” genera respuestas desde su memoria.
Un LLM con RAG consulta primero tus datos y responde con contexto real.
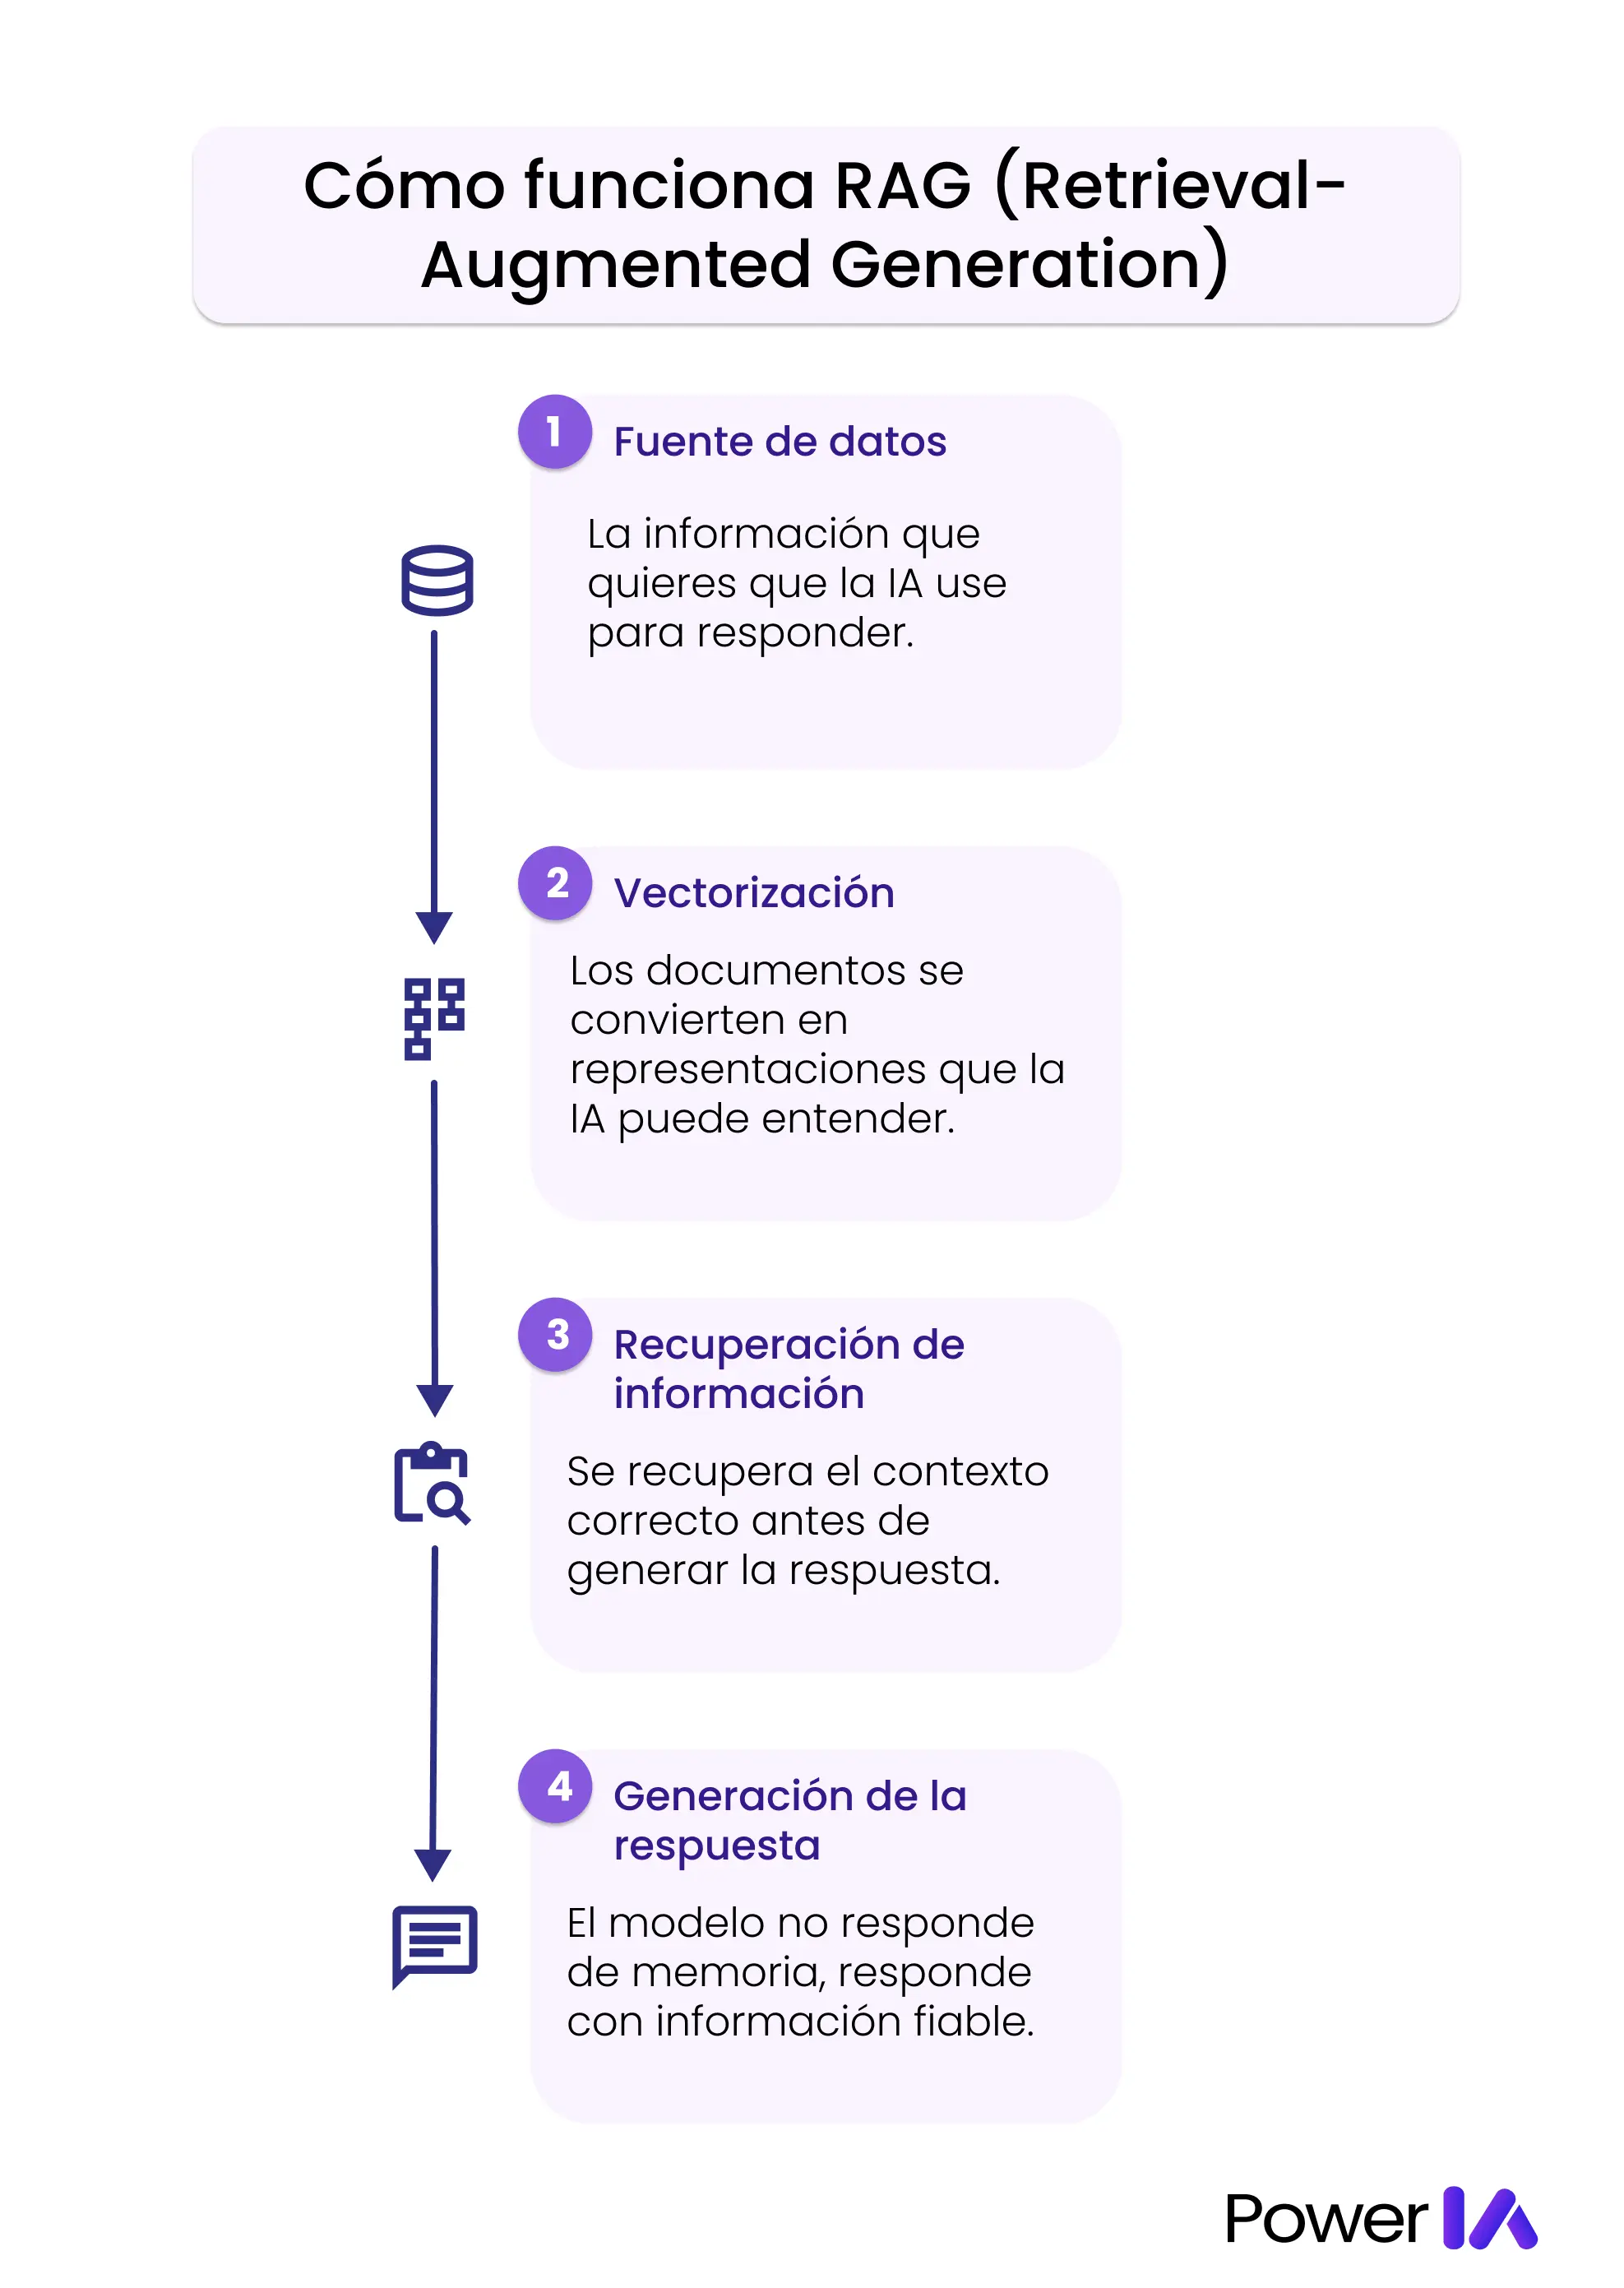
Cómo funciona RAG (paso a paso)
Aunque por dentro RAG es un sistema técnico, su lógica es bastante intuitiva si la ves como un flujo de trabajo. No hace falta saber programar para entenderlo.
Paso 1: Fuente de datos
Todo empieza con la información que quieres que la IA use como referencia.
Normalmente son:
Documentos internos
PDFs
Bases de conocimiento
FAQs
Políticas
Documentación técnica
Información comercial o legal
Clave: RAG no inventa datos nuevos, trabaja con información que tú le proporcionas.
Paso 2: Vectorización (embeddings)
Los documentos no se usan tal cual. Primero se transforman en un formato que la IA pueda “entender”.
De forma simplificada:
El texto se divide en fragmentos
Cada fragmento se convierte en un vector (una representación matemática de su significado)
No necesitas saber cómo funciona matemáticamente; lo importante es entender que la IA puede buscar por significado, no solo por palabras exactas.
Paso 3: Recuperación de información relevante
Cuando un usuario hace una pregunta, el sistema:
Analiza la pregunta
Busca en la base vectorial los fragmentos más relevantes
Selecciona solo la información que realmente tiene sentido para esa consulta
Este es el corazón del RAG: traer el contexto adecuado en el momento justo.
Paso 4: Generación de la respuesta con contexto
Por último, el LLM (ChatGPT, Gemini, Claude, etc.):
Recibe la pregunta del usuario
Recibe también los fragmentos recuperados
Genera la respuesta usando ese contexto como base.
El modelo no responde “de memoria”, sino apoyándose en datos reales y actuales.
RAG = buscar información relevante primero, generar la respuesta después.
Este flujo es lo que hace que RAG sea mucho más fiable que un LLM usado “a pelo”, especialmente en entornos profesionales.
Herramientas para montar un sistema RAG
Entender RAG a nivel conceptual es una cosa; saber con qué se construye, otra. En la práctica, un sistema RAG se apoya en tres tipos de piezas que trabajan juntas: un framework que orquesta el flujo, una base de datos vectorial que guarda la información y un modelo de embeddings que convierte el texto en vectores.
Pieza | Para qué sirve | Opciones habituales |
|---|---|---|
Framework de orquestación | Conecta los pasos: recuperar → construir el contexto → generar | LangChain, LlamaIndex |
Base de datos vectorial | Almacena y busca los fragmentos por significado | Pinecone, Weaviate, Chroma, pgvector |
Modelo de embeddings | Convierte el texto en vectores comparables | Modelos de OpenAI, Cohere o alternativas open source |
LLM generador | Redacta la respuesta final con el contexto recuperado | GPT, Claude, Gemini, Llama |
Selección orientativa a 2026. La elección depende del volumen de datos, del presupuesto y de si necesitas alojar todo en tu propia infraestructura.
Para un primer proyecto, una combinación habitual es LlamaIndex + una base vectorial gestionada como Pinecone (o pgvector si ya usas PostgreSQL) + el LLM que prefieras. No hace falta montar la pieza más sofisticada de cada categoría: hace falta que encajen entre sí.
Por qué RAG es clave en entornos profesionales
En entornos empresariales, el problema no es que la IA “no sepa responder”, sino que responde sin el contexto correcto. Y sin contexto, incluso el mejor modelo puede fallar.
RAG es clave porque cambia el orden de las cosas:
Primero recupera la información correcta, luego genera la respuesta.
Ese simple cambio marca una diferencia enorme cuando la IA se usa en procesos reales.
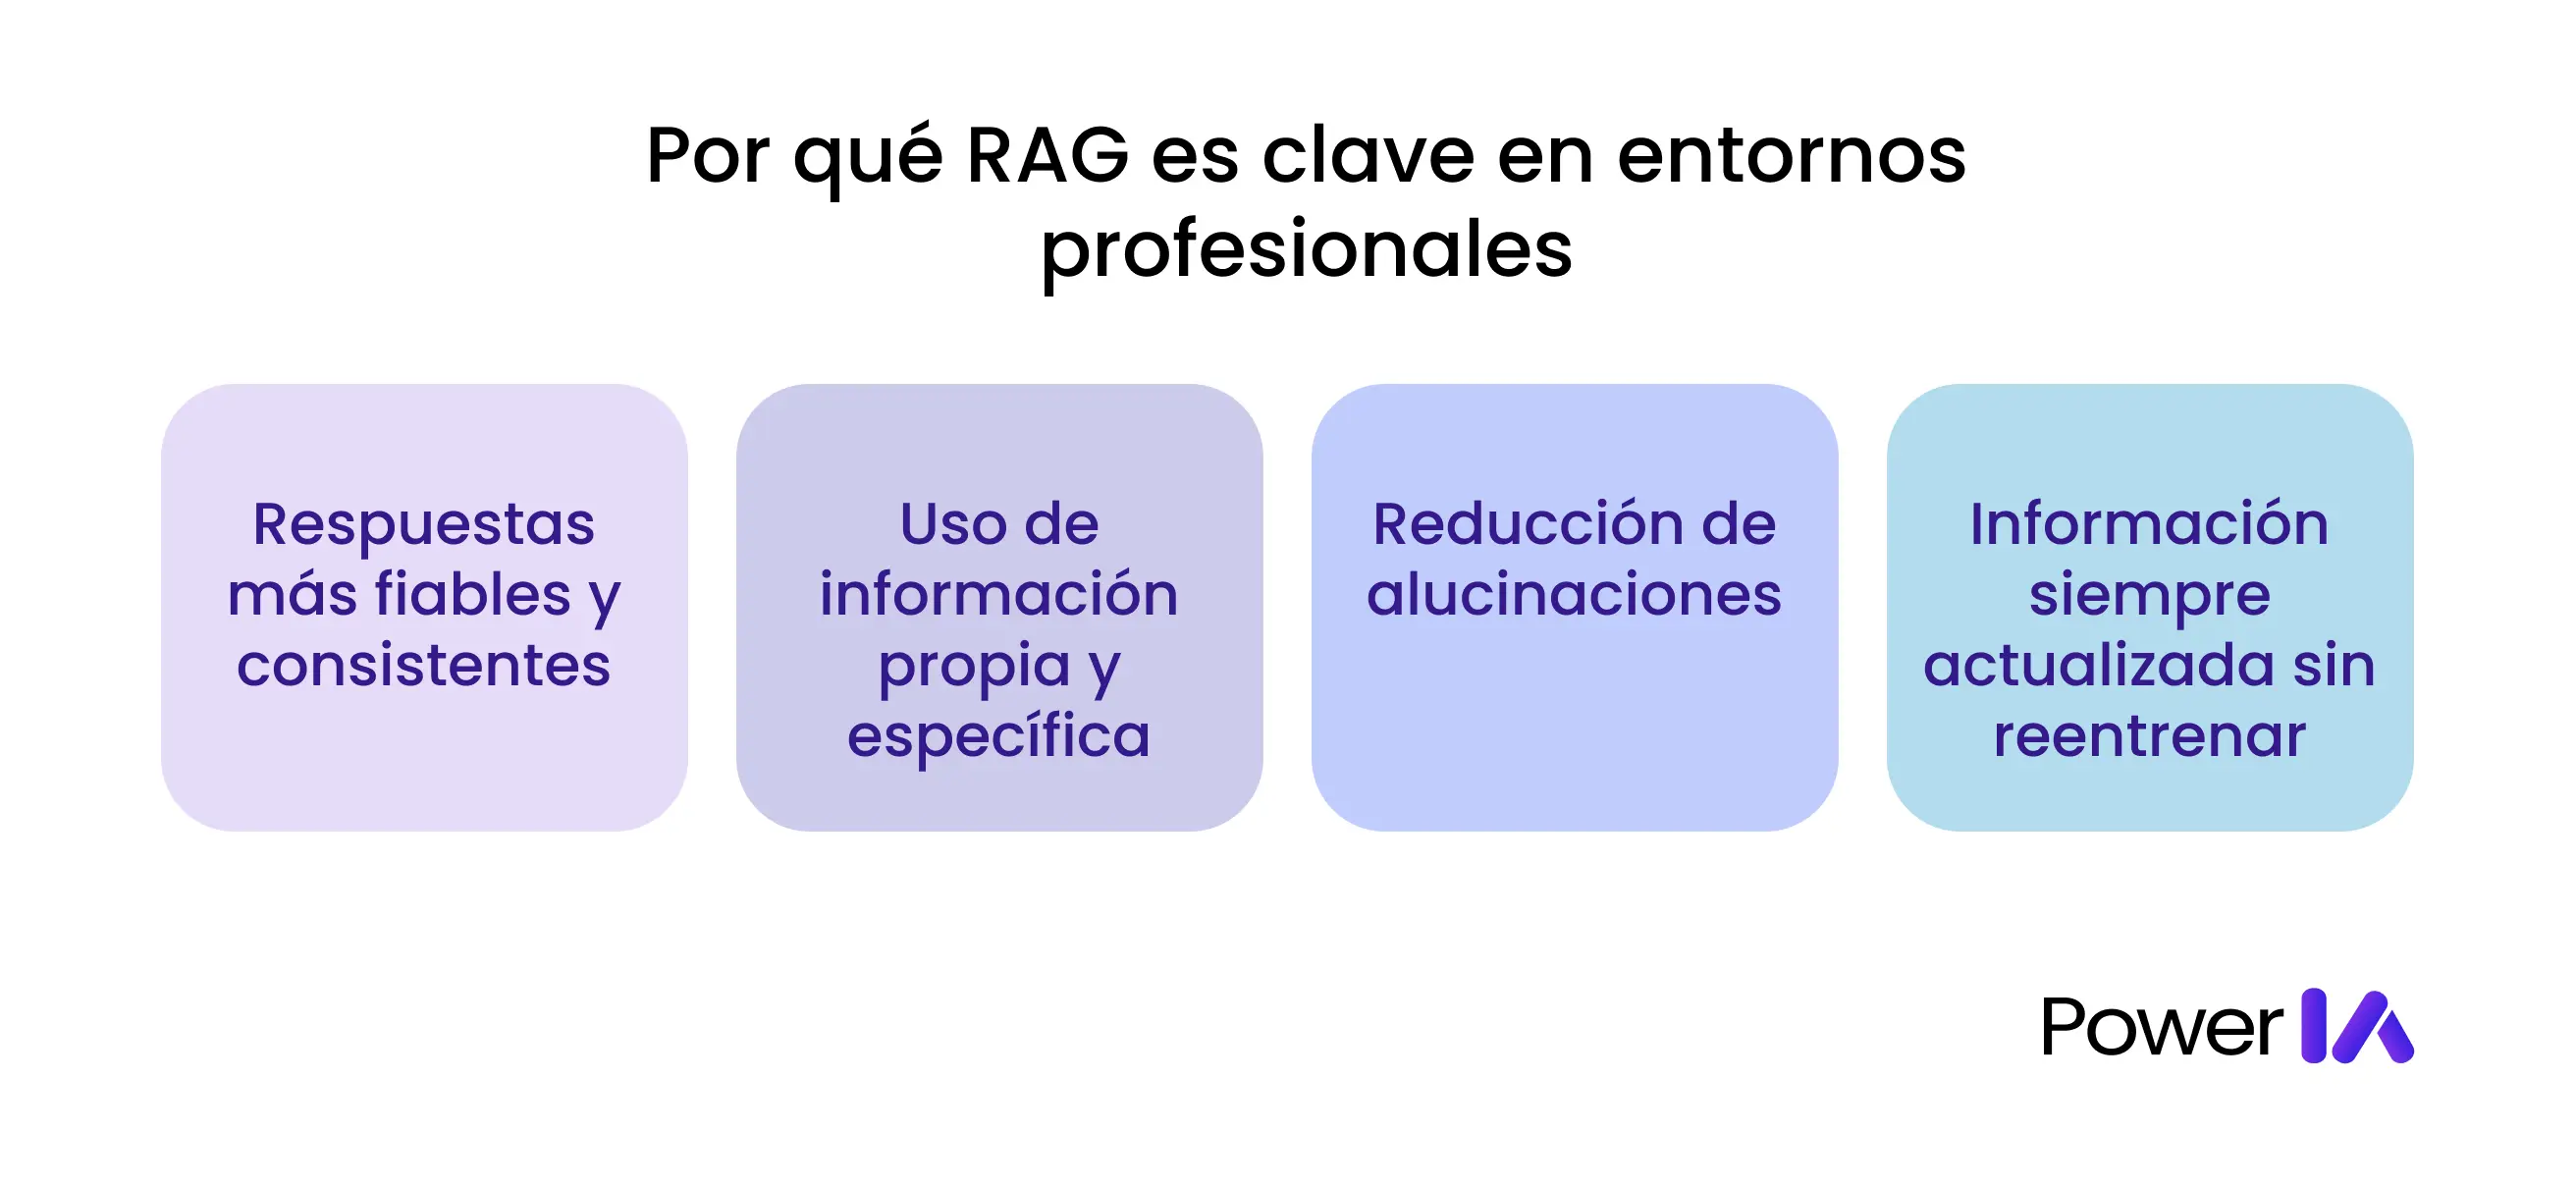
Respuestas más fiables y consistentes
En una empresa, no basta con que una respuesta “suene bien”. Tiene que ser correcta, coherente y repetible.
RAG permite que la IA:
Se base en documentos reales
Use siempre la misma fuente de verdad
Mantenga coherencia entre respuestas
Esto es fundamental en áreas como soporte, RRHH, legal o compliance, donde una respuesta incorrecta puede generar problemas reales.
Uso de información propia y específica
Uno de los grandes límites de los LLMs es que no conocen tu negocio.
No saben cómo funciona tu producto, tus políticas internas ni tus procesos.
Con RAG, la IA puede:
Consultar documentación interna
Usar FAQs corporativas
Responder según tus reglas y procedimientos
Adaptarse a tu contexto específico
La IA deja de ser genérica y empieza a comportarse como alguien “formado dentro de la empresa”.
Reducción de alucinaciones
Las alucinaciones aparecen cuando el modelo no tiene datos claros y “rellena” los huecos.
RAG reduce este problema porque:
El modelo no tiene que inventar
Responde apoyándose en fragmentos reales
Puede incluso citar o justificar la información usada
No elimina el riesgo al 100 %, pero lo reduce drásticamente, especialmente en preguntas operativas o técnicas.
Información siempre actualizada sin reentrenar modelos
Entrenar o reentrenar un modelo es costoso, lento y complejo.
Con RAG:
Basta con actualizar los documentos
Añadir nueva información
Eliminar contenido obsoleto
La IA empezará a responder con esos cambios sin tocar el modelo base. Esto es clave en empresas donde la información cambia constantemente.
Para que no quede en abstracto: pensemos en un equipo de soporte de una empresa de software con unos 300 artículos de ayuda, políticas de producto y un histórico de tickets.
Sin RAG, el asistente de IA respondía “de memoria” y se inventaba pasos que no existían en la documentación real. Con RAG conectado a esa base de conocimiento, el sistema recupera primero los 3 o 4 fragmentos relevantes de la documentación oficial y responde solo con eso, citando de qué artículo salió cada dato.
El resultado no es “una IA más lista”, sino respuestas que el equipo puede verificar y en las que el cliente puede confiar. Ese es el cambio que hace que RAG pase de demo a herramienta de trabajo.
RAG vs Fine-Tuning: ¿en qué se diferencian?
Cuando una empresa quiere que un modelo de IA “sepa más”, suelen aparecer dos opciones: RAG o fine-tuning. Aunque a veces se presentan como alternativas similares, resuelven problemas distintos.
En esta tabla intentamos dejártelo claro:
Aspecto | RAG (Retrieval-Augmented Generation) | Fine-Tuning |
|---|---|---|
Qué hace | Añade contexto externo a cada respuesta | Modifica el comportamiento del modelo |
Tipo de información | Datos y documentos externos | Conocimiento “internalizado” en el modelo |
Actualización de datos | Muy fácil (actualizas documentos) | Compleja (requiere reentrenar) |
Coste | Bajo–medio | Alto |
Tiempo de implementación | Rápido | Lento |
Mantenimiento | Sencillo | Costoso |
Flexibilidad | Muy alta | Baja |
Riesgo de obsolescencia | Bajo | Alto si cambian los datos |
Casos ideales | Documentación, soporte, RRHH, ventas, compliance | Estilo de respuesta, tono, tareas muy específicas |
Errores comunes al implementar RAG
RAG es potente, pero no funciona por sí solo. Cuando los resultados no son buenos, casi nunca es “culpa del modelo”, sino de cómo se ha planteado la solución. Estos son los errores más habituales en entornos reales.
Datos mal preparados o poco claros
RAG depende totalmente de la calidad de los documentos.
Errores frecuentes:
Documentos desactualizados
PDFs mal estructurados
Información duplicada o contradictoria
Textos demasiado largos sin dividir
Si la fuente es confusa, la respuesta también lo será.
No actualizar las fuentes
Uno de los mayores beneficios de RAG es poder actualizar información sin reentrenar modelos. Paradójicamente, muchas empresas olvidan mantener los documentos al día.
Resultado:
Respuestas correctas… pero obsoletas
Pérdida de confianza en el sistema
RAG necesita un proceso de actualización, no solo una implementación inicial.
Prompts mal diseñados
RAG no elimina la necesidad de buenos prompts.
Errores comunes:
No indicar cómo usar el contexto recuperado
No pedir respuestas basadas solo en la información encontrada
No definir tono, formato o nivel de detalle
Un mal prompt puede hacer que el modelo ignore el contexto recuperado.
Esperar “magia” sin una estrategia
RAG no sustituye el pensamiento crítico ni el diseño de procesos.
Errores típicos:
Conectar documentos “a la buena de Dios”
No definir casos de uso claros
No probar ni validar resultados
Asumir que el sistema siempre acertará
RAG funciona mejor cuando hay objetivos claros y expectativas realistas.
RAG es el puente entre la IA genérica y la IA útil en empresa
Los modelos de lenguaje son potentes, pero por sí solos no son suficientes para entornos profesionales. El verdadero salto de valor ocurre cuando la IA deja de responder “de memoria” y empieza a hacerlo con contexto real, datos propios y fuentes verificables.
Eso es exactamente lo que permite RAG.
Gracias a esta arquitectura, las empresas pueden usar IA para:
Responder con información fiable
Aprovechar su propio conocimiento interno
Reducir errores y alucinaciones
Mantener los sistemas actualizados sin reentrenar modelos
Escalar casos de uso reales en soporte, ventas, RRHH o compliance
RAG no consiste en hacer la IA más inteligente, sino en hacerla más útil. Y en el mundo empresarial, utilidad y fiabilidad valen más que creatividad sin contexto.
Si quieres avanzar hacia una IA aplicada, conectada a datos reales y pensada para procesos de negocio, entender RAG ya no es opcional: es parte del nuevo estándar.
RAG en 2026: hacia el RAG agéntico
RAG no se ha quedado quieto. La evolución que más está sonando en 2026 es el RAG agéntico: en lugar de recuperar una sola vez y responder, un agente de IA decide qué buscar, evalúa si lo recuperado es suficiente y, si no lo es, vuelve a consultar otras fuentes antes de responder. Es RAG con capacidad de decisión, no un único paso fijo.
En paralelo, la línea entre RAG y protocolos de conexión como MCP se difumina: un sistema puede usar RAG para el conocimiento estático (documentación, manuales) y MCP para acceder a datos en vivo (el estado de un pedido, una consulta a la base de datos). No compiten; en los sistemas serios de 2026, conviven.
FAQs sobre RAG
¿RAG necesita saber programar?
No necesariamente. Aunque la implementación técnica suele requerir perfiles especializados, entender RAG y definir casos de uso no requiere programar. Muchos profesionales trabajan con RAG a nivel funcional y estratégico sin escribir código.
¿RAG sustituye al fine-tuning?
No. RAG y fine-tuning resuelven problemas distintos. RAG se usa para aportar contexto y datos actualizados; el fine-tuning sirve para modificar el comportamiento o estilo del modelo. En la mayoría de casos empresariales, RAG es suficiente.
¿Se puede usar RAG con ChatGPT u otros LLMs?
Sí. RAG no depende de un modelo concreto. Puede utilizarse con distintos LLMs siempre que se puedan combinar con una capa de recuperación de información externa.
¿RAG reduce las alucinaciones de la IA?
Sí, de forma significativa. Al basarse en documentos reales y recuperarlos antes de generar la respuesta, el modelo tiene menos necesidad de “inventar” información.
¿Para qué tipo de empresas tiene más sentido usar RAG?
RAG es especialmente útil en empresas que manejan mucha documentación interna, información sensible o procesos complejos: soporte, atención al cliente, ventas, RRHH, legal, compliance o conocimiento corporativo.
¿Cuándo conviene RAG y cuándo basta con un modelo de ventana de contexto muy grande?
Si la información cabe holgadamente en el prompt y no cambia, una ventana de contexto grande puede ser suficiente y más simple. RAG gana cuando tienes mucha documentación (miles de páginas), cuando cambia con frecuencia o cuando necesitas trazabilidad de qué fuente usó el modelo. En volumen y coste, recuperar solo lo relevante suele salir más barato que meterlo todo en cada consulta.
¿Qué base de datos vectorial elegir para un primer proyecto?
Para empezar sin complicarte, una opción gestionada como Pinecone reduce el mantenimiento. Si ya usas PostgreSQL, pgvector te evita añadir una herramienta nueva. Y si quieres algo ligero y local para prototipar, Chroma es de las más rápidas de montar. La decisión importa menos al principio de lo que parece: casi todas sirven para un primer caso.
¿Se pueden combinar RAG y MCP en el mismo sistema?
Sí, y es cada vez más habitual. RAG aporta el conocimiento estático (tus documentos); MCP conecta el modelo con sistemas en vivo (CRM, bases de datos, herramientas). Un asistente empresarial bien construido en 2026 suele usar los dos.
¿Cómo se mide si un sistema RAG funciona bien?
Con dos ideas clave: la recuperación (¿está trayendo los fragmentos correctos?) y la fidelidad de la respuesta (¿se apoya de verdad en esos fragmentos o se los salta?). Si las respuestas fallan, casi siempre el problema está en la recuperación o en la calidad de los documentos, no en el LLM.
¿Cuánto cuesta, de forma orientativa, montar un RAG básico para una pyme?
Depende del volumen, pero un piloto para un caso concreto (una base de conocimiento de soporte, por ejemplo) suele moverse en costes bajos de infraestructura al mes más el uso de la API del modelo. El grueso del esfuerzo no es el gasto, sino preparar bien los documentos y definir el caso de uso.